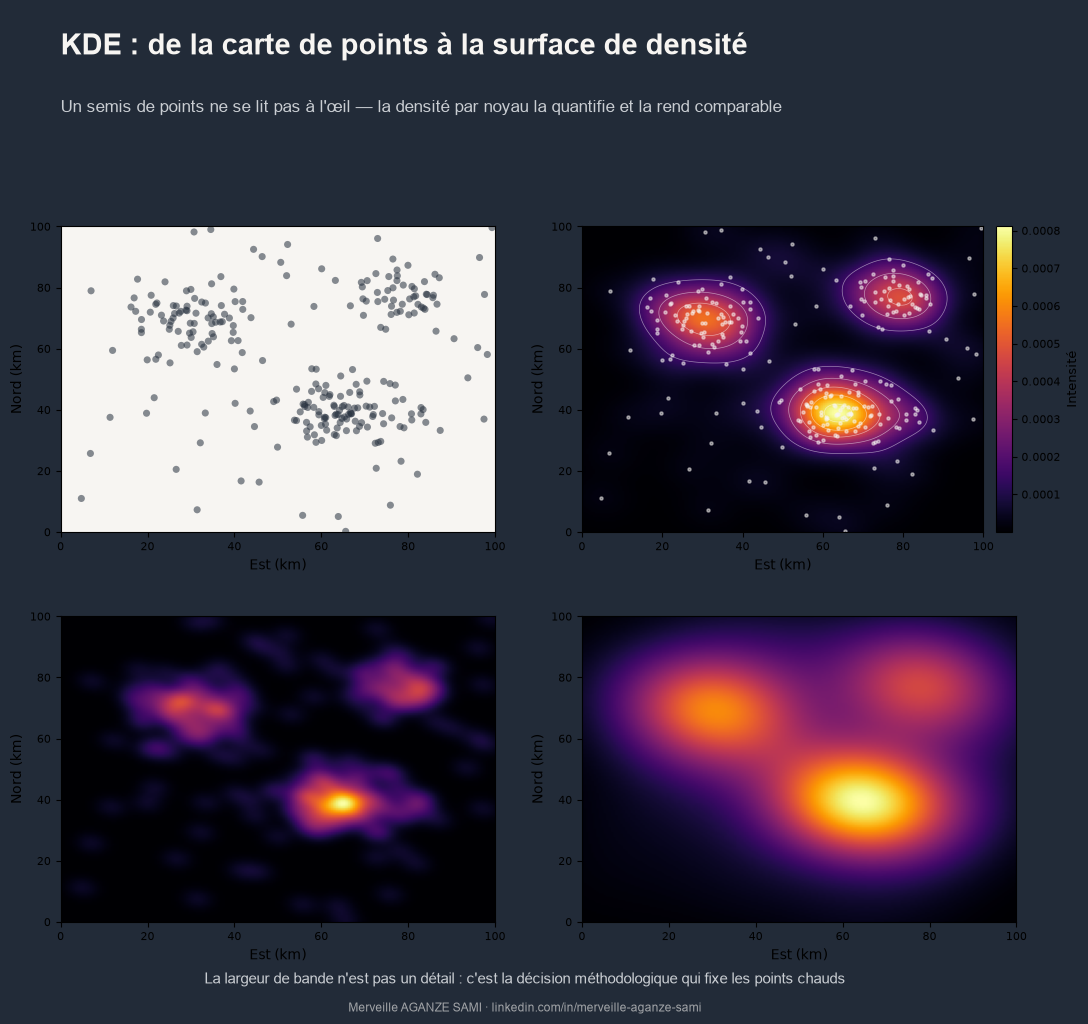
La représentation d'événements géolocalisés — incidents, plaintes, ménages bénéficiaires, cas signalés — prend fréquemment la forme d'un semis de points sur un fond de carte. Cette représentation présente une limite structurelle : elle délègue à la perception visuelle l'estimation de la concentration, alors que celle-ci devrait relever de la mesure.
Trois biais s'y ajoutent. Les points superposés masquent leur propre effectif. Les zones densément peuplées dominent visuellement, indépendamment de l'intensité relative du phénomène. Enfin, deux lecteurs examinant la même carte identifient rarement les mêmes regroupements.
L'estimation de densité par noyau, développée dans le cadre de l'estimation non paramétrique de densité (Rosenblatt, 1956) (Parzen, 1962), substitue à cette appréciation une grandeur calculée et reproductible.
1. Principe
La méthode consiste à remplacer chaque observation ponctuelle par une fonction de pondération — le noyau — centrée sur ce point et décroissante avec la distance. La somme de ces contributions en tout point du plan produit une surface continue dont la valeur exprime une intensité, généralement en événements par unité de surface.
Deux paramètres définissent l'estimation. La forme du noyau (gaussien, quartique, triangulaire) détermine la manière dont l'influence décroît ; son effet sur le résultat reste modéré. La largeur de bande, en revanche, conditionne fortement la sortie : elle fixe le rayon d'influence de chaque observation (Silverman, 1986).
Le paramètre décisif. Une largeur de bande étroite produit une surface fragmentée où chaque point isolé apparaît comme un foyer ; une largeur élevée lisse la structure au point de faire disparaître les concentrations réelles. Le choix de ce paramètre détermine donc le nombre et l'étendue des points chauds identifiés — il constitue une décision méthodologique à part entière, non un réglage d'affichage.
2. Choisir et justifier la largeur de bande
Plusieurs approches permettent de fonder ce choix plutôt que de le laisser à la valeur par défaut du logiciel.
- Règles automatiques. Des estimateurs fondés sur la dispersion des données fournissent une valeur de départ objective ; ils supposent toutefois une distribution proche de la normale et tendent à sur-lisser les semis multimodaux (Silverman, 1986).
- Validation croisée. La largeur est sélectionnée de façon à optimiser un critère de qualité d'ajustement, ce qui offre une justification statistique explicite (Diggle, 2013).
- Critère thématique. La largeur peut être fixée à partir d'une distance ayant un sens opérationnel — rayon de desserte d'un centre de santé, distance de marche acceptable, portée d'une zone d'intervention. Cette approche est souvent la plus défendable devant un partenaire.
- Noyau adaptatif. Lorsque la densité varie fortement dans l'espace, une largeur variable, plus étroite dans les zones denses, améliore la restitution des structures locales.
3. Densité brute ou risque relatif
Une précaution majeure concerne l'interprétation. Une surface de densité brute reflète en partie la répartition de la population sous-jacente : les zones peuplées produisent mécaniquement davantage d'événements. Conclure d'une densité élevée à un besoin prioritaire revient alors à cartographier la démographie.
Lorsque la question porte sur une intensité relative — un taux plutôt qu'un volume — il convient d'estimer un rapport entre la densité des cas et celle d'une population de référence. Cette approche du risque relatif est formalisée dans la littérature d'épidémiologie spatiale et s'applique de la même manière aux données de projet (Kelsall & Diggle, 1995).
4. Autres limites à documenter
- Effets de bord. Aux limites de la zone d'étude, une partie du noyau porte sur l'extérieur du domaine, ce qui sous-estime la densité en périphérie. Des corrections existent et devraient être appliquées lorsque les bords concentrent des enjeux.
- Barrières physiques. Le noyau diffuse en distance euclidienne, sans tenir compte des rivières, reliefs ou limites administratives. Pour des phénomènes contraints par un réseau, une densité calculée le long du réseau est plus appropriée.
- Comparabilité temporelle. Deux cartes produites avec des largeurs de bande ou des échelles de couleur différentes ne sont pas comparables. Ces paramètres doivent être figés pour tout suivi dans la durée.
- Absence de test. La KDE décrit une intensité mais ne teste pas la significativité d'un regroupement. Lorsque la question est de savoir si une concentration excède ce qu'expliquerait le hasard, elle doit être complétée par une statistique dédiée.
5. Usage opérationnel
Correctement paramétrée et documentée, la surface de densité transforme une illustration en instrument de ciblage. Elle fournit des zones prioritaires délimitées selon un critère explicite, comparables d'une période à l'autre, et dont la construction peut être reproduite par un tiers — condition d'une priorisation défendable devant un partenaire ou un bailleur.
Points essentiels
- La KDE remplace l'appréciation visuelle d'un semis par une intensité calculée
- La largeur de bande est le paramètre déterminant : elle fixe le nombre et l'étendue des foyers
- Une largeur fondée sur une distance opérationnelle est souvent la plus défendable
- Une densité brute reflète en partie la population : pour un taux, estimer un risque relatif
- Figer largeur de bande et échelle de couleurs pour tout suivi comparatif
Un semis de points indique où des événements ont été enregistrés. Une surface de densité indique où ils se concentrent. Ces deux informations n'appellent pas la même décision.
Références
- Diggle, P. J. (2013). Statistical Analysis of Spatial and Spatio-Temporal Point Patterns (3rd ed.). Boca Raton: CRC Press. doi.org/10.1201/b15326
- Kelsall, J. E., & Diggle, P. J. (1995). Kernel estimation of relative risk. Bernoulli, 1(1–2), 3–16. doi.org/10.2307/3318678
- Parzen, E. (1962). On Estimation of a Probability Density Function and Mode. The Annals of Mathematical Statistics, 33(3), 1065–1076. doi.org/10.1214/aoms/1177704472
- Rosenblatt, M. (1956). Remarks on Some Nonparametric Estimates of a Density Function. The Annals of Mathematical Statistics, 27(3), 832–837. doi.org/10.1214/aoms/1177728190
- Silverman, B. W. (1986). Density Estimation for Statistics and Data Analysis. London: Chapman & Hall. doi.org/10.1201/9781315140919

Merveille Aganze Sami
Conseillère MEL & Gestion de Bases de Données. Plus de 9 ans d'expérience en suivi-évaluation, SIG et digitalisation auprès d'organisations internationales (GIZ, Enabel) en RD Congo.
Des données de terrain géolocalisées à exploiter ?
Prendre contact