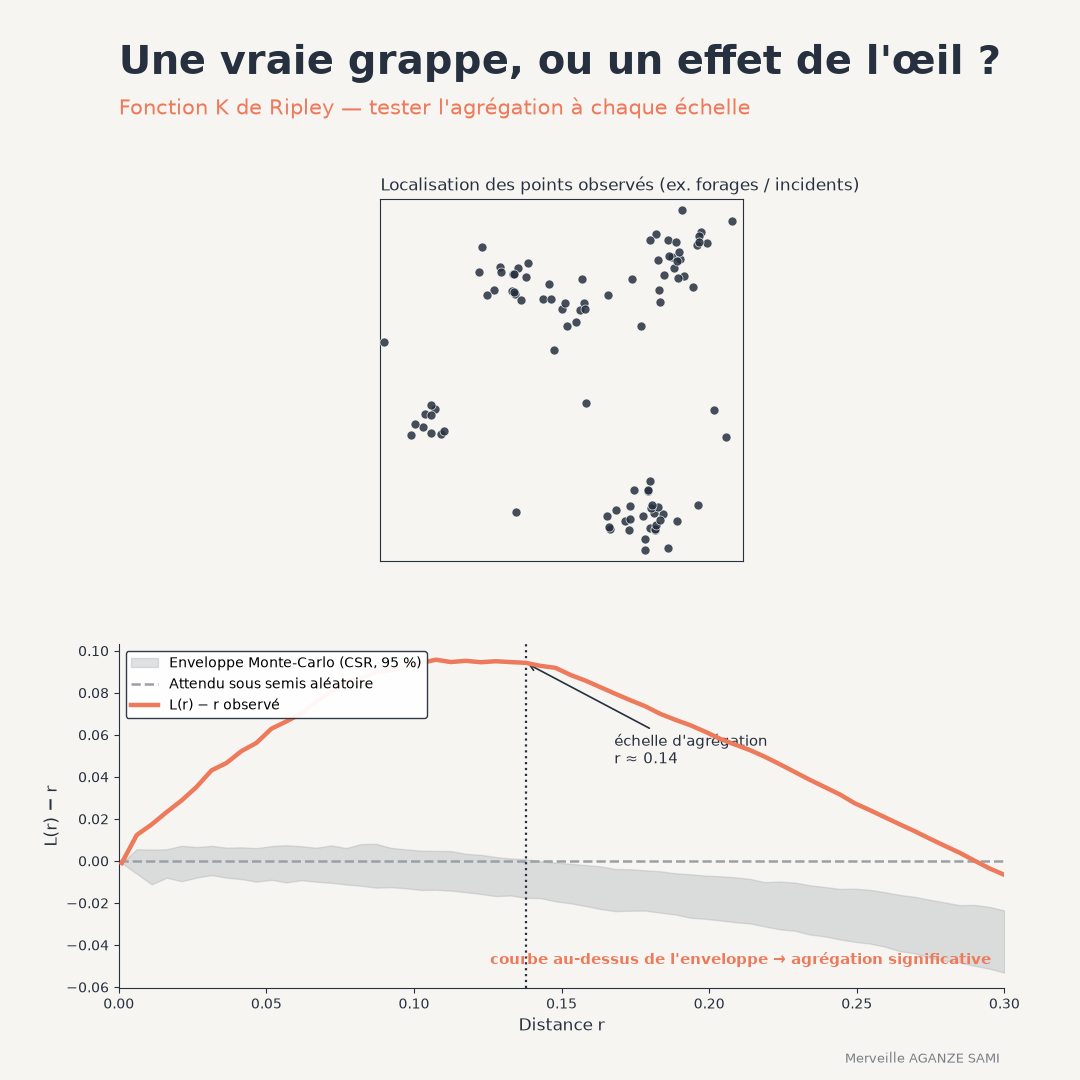
La lecture d'une carte de points — forages, incidents signalés, ménages bénéficiaires, foyers de maladie — conduit fréquemment à identifier des regroupements et à en tirer des conclusions opérationnelles. Cette lecture se heurte à une propriété bien établie de la perception visuelle : une répartition entièrement aléatoire produit elle aussi des amas apparents, souvent convaincants.
La question à laquelle une analyse doit répondre n'est donc pas de savoir si des regroupements sont visibles, mais si leur intensité excède ce qu'une répartition sans structure produirait, et à quelle distance cet écart se manifeste.
1. Ce que mesure la fonction K
La fonction K se définit, pour une distance donnée, comme le nombre moyen de points situés à moins de cette distance d'un point quelconque du semis, rapporté à l'intensité générale du semis. Elle décrit donc la structure du voisinage à toutes les échelles simultanément, et non à une seule (Ripley, 1976).
Sous une hypothèse de répartition complètement aléatoire, cette quantité prend une valeur théorique connue, proportionnelle à la surface du disque de rayon considéré. La comparaison entre valeur observée et valeur théorique fournit le diagnostic : une valeur supérieure indique davantage de voisins qu'attendu — agrégation ; une valeur inférieure indique une répartition plus régulière — dispersion (Ripley, 1977).
La transformation en fonction L. La fonction K croît avec le carré de la distance, ce qui rend la lecture graphique malaisée et la variance inégale selon l'échelle. Une transformation usuelle stabilise cette variance et ramène la valeur théorique à une droite, voire à une ligne horizontale lorsqu'on soustrait la distance. L'écart à cette référence se lit alors directement, à toutes les distances.
2. L'enveloppe de simulation
Une différence entre courbe observée et courbe théorique ne suffit pas à conclure : encore faut-il savoir quel écart un semis réellement aléatoire produirait. La procédure consiste à simuler un grand nombre de semis sous le modèle nul, à calculer la fonction pour chacun, et à en déduire une bande de valeurs plausibles. La courbe observée est comparée à cette bande.
Cette construction appelle une précaution importante. Une enveloppe calculée distance par distance ne constitue pas un test valide de l'ensemble de la courbe : la courbe étant examinée sur une plage continue de distances, la probabilité qu'elle sorte de l'enveloppe en au moins un point dépasse largement le seuil affiché. Des enveloppes dites globales, ou des tests fondés sur un écart agrégé, corrigent ce défaut et devraient être préférées lorsqu'une conclusion formelle est recherchée (Baddeley et al., 2014).
3. Les effets de bord
Un point situé près de la limite de la zone d'étude possède une partie de son voisinage hors du domaine observé. Sans correction, le nombre de voisins est systématiquement sous-estimé pour ces points, ce qui biaise la fonction vers une apparence de dispersion. Plusieurs corrections existent — pondération par la fraction de disque incluse, correction par translation, méthode de la fenêtre réduite — et leur application n'est pas optionnelle dès lors que la zone est de petite taille par rapport aux distances examinées (Diggle, 2013).
4. Le choix du modèle nul
C'est le point le plus déterminant, et le plus souvent négligé. L'hypothèse de répartition complètement aléatoire suppose une intensité constante sur toute la zone d'étude. Or les phénomènes suivis en contexte de projet ne remplissent presque jamais cette condition : les incidents se produisent là où vivent les personnes, les forages sont implantés là où existent des villages.
Une intensité variable dans l'espace produit alors une agrégation apparente qui ne traduit aucune interaction entre points, mais seulement la répartition sous-jacente de la population ou des infrastructures. Deux réponses sont possibles : utiliser une version de la fonction qui admet une intensité non constante, estimée séparément — ce qui rejoint la démarche exposée dans l'article sur l'estimation par noyau — ou construire un modèle nul reflétant explicitement le processus de répartition attendu (Wiegand & Moloney, 2004).
Cette décision doit précéder le calcul. Un résultat d'agrégation obtenu sous un modèle nul inadapté n'apporte aucune information sur le phénomène étudié.
5. Ce que la courbe apporte à une décision
L'apport opérationnel principal réside dans l'identification d'une échelle. La distance à laquelle l'écart à la référence est maximal indique la portée du processus d'agrégation : c'est l'échelle à laquelle les événements se regroupent effectivement. Cette information oriente directement le dimensionnement d'une réponse — rayon d'une zone d'intervention, maillage d'un dispositif de surveillance, distance entre points de service.
Elle permet également de distinguer des situations que la seule cartographie confond : un semis peut être agrégé à petite échelle et régulier à grande échelle, configuration fréquente lorsque des grappes locales se répartissent uniformément sur le territoire. Des fonctions apparentées, fondées sur les distances entre points plutôt que sur un cumul, permettent d'affiner cette lecture (Baddeley et al., 2015).
Points essentiels
- Une répartition aléatoire produit des amas visuellement convaincants
- La fonction K compare le voisinage observé à une référence, à toutes les distances
- Une enveloppe calculée point par point n'est pas un test valide de l'ensemble de la courbe
- Les corrections de bord sont nécessaires dès que la zone est petite au regard des distances étudiées
- Le modèle nul est la décision principale : une intensité non constante crée une agrégation apparente
Une carte indique où se trouvent les points. L'analyse de leur structure indique si leur agencement présente une régularité, et à quelle échelle. C'est cette seconde information qui permet de dimensionner une réponse.
Références
- Baddeley, A., Rubak, E., & Turner, R. (2015). Spatial Point Patterns: Methodology and Applications with R. Boca Raton: CRC Press.
- Baddeley, A., Diggle, P. J., Hardegen, A., Lawrence, T., Milne, R. K., & Nair, G. (2014). On tests of spatial pattern based on simulation envelopes. Ecological Monographs, 84(3), 477–489. doi.org/10.1890/13-2042.1
- Diggle, P. J. (2013). Statistical Analysis of Spatial and Spatio-Temporal Point Patterns (3rd ed.). Boca Raton: CRC Press. doi.org/10.1201/b15326
- Ripley, B. D. (1976). The second-order analysis of stationary point processes. Journal of Applied Probability, 13(2), 255–266. doi.org/10.2307/3212829
- Ripley, B. D. (1977). Modelling Spatial Patterns. Journal of the Royal Statistical Society: Series B, 39(2), 172–212. doi.org/10.1111/j.2517-6161.1977.tb01615.x
- Wiegand, T., & Moloney, K. A. (2004). Rings, circles, and null-models for point pattern analysis in ecology. Oikos, 104(2), 209–229. doi.org/10.1111/j.0030-1299.2004.12497.x

Merveille Aganze Sami
Conseillère MEL & Gestion de Bases de Données. Plus de 9 ans d'expérience en suivi-évaluation, SIG et digitalisation auprès d'organisations internationales (GIZ, Enabel) en RD Congo.
Un semis de points à analyser ?
Prendre contact