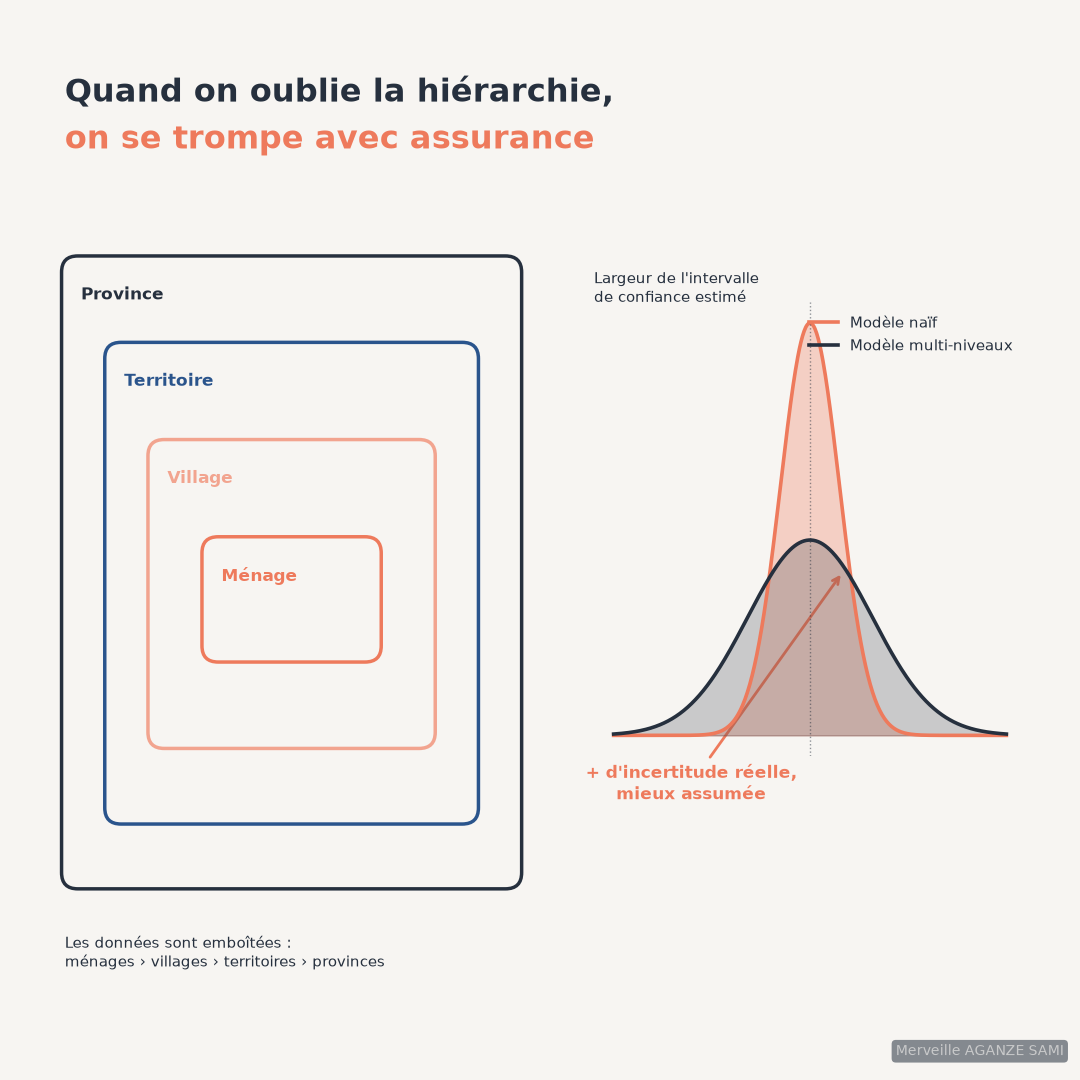
Les données produites par un dispositif de suivi présentent presque toujours une structure emboîtée : des ménages appartiennent à des villages, ces villages à des territoires, ces territoires à des provinces. Cette organisation n'est pas une commodité de présentation ; elle a une conséquence statistique directe.
Deux ménages d'un même village partagent un environnement, un marché, un accès aux services, souvent une histoire commune. Leurs observations sont donc corrélées. Une analyse qui les traite comme indépendantes suppose implicitement que chaque ménage apporte une quantité d'information équivalente, ce qui n'est pas le cas : au sein d'une grappe homogène, chaque observation supplémentaire apporte moins que la précédente.
1. La conséquence : des intervalles trop étroits
L'effet de cette corrélation est bien documenté. Il se traduit par un facteur multiplicateur appliqué à la variance de l'estimateur, souvent désigné comme effet de plan. Selon l'intensité de la corrélation interne et le nombre d'unités par grappe, ce facteur peut atteindre plusieurs unités, ce qui signifie que l'intervalle de confiance réel est sensiblement plus large que celui produit par un calcul standard.
La difficulté n'est pas seulement d'obtenir un chiffre erroné : c'est d'obtenir un chiffre erroné assorti d'une précision affichée qui ne correspond à rien. Une différence déclarée significative peut ne pas l'être une fois la structure prise en compte.
La corrélation intra-classe. Cette grandeur exprime la part de la variabilité totale qui se situe entre les grappes plutôt qu'à l'intérieur. Une valeur proche de zéro indique que les villages se ressemblent et que la structure importe peu ; une valeur élevée indique au contraire que l'appartenance à un village détermine largement la valeur observée. Elle constitue le premier résultat à examiner, avant toute interprétation des coefficients (Snijders & Bosker, 2012).
2. Ce qu'apporte un modèle à effets aléatoires
Le modèle introduit, pour chaque niveau de la hiérarchie, un terme aléatoire représentant l'écart propre à chaque unité de ce niveau. Il estime simultanément les effets communs — ceux qui valent pour l'ensemble de la population — et la dispersion entre grappes. Trois apports en découlent.
- Des erreurs-types cohérentes avec la structure. L'incertitude reportée intègre la corrélation interne aux grappes plutôt que de l'ignorer.
- Une décomposition de la variance. Le modèle indique quelle part de la variation s'explique par les caractéristiques du ménage et quelle part par le contexte local, information qu'une régression ordinaire ne fournit pas.
- Une estimation stabilisée par grappe. Les estimations propres à chaque village sont ramenées vers la moyenne générale d'autant plus fortement que la grappe compte peu d'observations, ce qui limite les valeurs extrêmes issues de faibles effectifs (Gelman & Hill, 2007).
3. Les conditions de mise en œuvre
- 1Un nombre suffisant de grappes. C'est la contrainte principale, et elle porte sur le nombre de villages, non sur le nombre de ménages. En deçà d'une cinquantaine de grappes, l'estimation des variances de second niveau et des erreurs-types associées devient biaisée (Maas & Hox, 2005). Des correctifs existent pour les cas où ce seuil ne peut être atteint (McNeish & Stapleton, 2016).
- 2Un choix explicite d'effets aléatoires. Autoriser seulement la constante à varier par village, ou également la pente d'une variable, correspond à deux hypothèses distinctes : un effet identique partout, ou un effet dont l'intensité dépend du contexte.
- 3Un traitement réfléchi du centrage. Une variable de niveau ménage peut être centrée sur la moyenne générale ou sur la moyenne de son village. Ce choix modifie l'interprétation du coefficient — écart à l'ensemble de la population, ou écart aux voisins — et n'est pas neutre (Enders & Tofighi, 2007).
- 4Une distinction entre variables de niveaux différents. La distance au marché caractérise le village, la taille du ménage caractérise le ménage. Les introduire sans distinction dans un même modèle conduit à des interprétations confuses.
4. Articulation avec le plan d'échantillonnage
La structure du modèle devrait refléter celle du plan de sondage. Lorsque l'enquête a été construite par grappes — ce qui est le cas de la plupart des enquêtes de terrain — les unités primaires de tirage constituent le niveau naturel des effets aléatoires. Cette cohérence entre plan et analyse est un point de contrôle utile, développé dans l'article consacré à l'échantillonnage spatialement stratifié.
Une alternative plus légère consiste à conserver une régression ordinaire en corrigeant les erreurs-types au niveau des grappes. Cette solution règle la question de l'inférence mais ne fournit ni la décomposition de la variance ni les estimations par grappe. Elle convient lorsque la structure est une nuisance à corriger ; le modèle complet convient lorsque la structure est elle-même un objet d'analyse.
- Confondre niveau d'analyse et niveau de conclusion. Un effet estimé au niveau du village ne s'applique pas mécaniquement à un ménage particulier. Transposer l'un à l'autre constitue une erreur d'inférence classique.
- Grappes de tailles très inégales. Un village de trois ménages et un village de quatre-vingts ne contribuent pas de la même manière. Les effectifs par grappe doivent être reportés.
- Convergence des estimations. Les modèles complexes appliqués à des données peu nombreuses échouent fréquemment à converger. Simplifier la structure aléatoire est préférable à forcer l'estimation.
- Trois niveaux ou plus. Chaque niveau supplémentaire exige un nombre suffisant d'unités à ce niveau. Introduire un niveau provincial avec quatre provinces n'apporte aucune information exploitable.
Points essentiels
- Les données de terrain sont presque toujours emboîtées, ce qui corrèle les observations d'une même grappe
- Ignorer cette structure produit des intervalles trop étroits et une significativité surestimée
- La corrélation intra-classe est le premier résultat à examiner
- La contrainte porte sur le nombre de grappes, pas sur le nombre d'observations
- La structure du modèle devrait refléter celle du plan d'échantillonnage
La dimension géographique d'un dispositif de suivi n'est pas seulement un objet de cartographie : elle constitue une hypothèse statistique. Lorsqu'elle est négligée, l'erreur ne porte pas seulement sur l'estimation, mais sur la confiance qu'on lui accorde.
Références
- Enders, C. K., & Tofighi, D. (2007). Centering predictor variables in cross-sectional multilevel models: A new look at an old issue. Psychological Methods, 12(2), 121–138. doi.org/10.1037/1082-989X.12.2.121
- Gelman, A., & Hill, J. (2007). Data Analysis Using Regression and Multilevel/Hierarchical Models. New York: Cambridge University Press.
- Maas, C. J. M., & Hox, J. J. (2005). Sufficient Sample Sizes for Multilevel Modeling. Methodology, 1(3), 86–92. doi.org/10.1027/1614-2241.1.3.86
- McNeish, D. M., & Stapleton, L. M. (2016). The Effect of Small Sample Size on Two-Level Model Estimates: A Review and Illustration. Educational Psychology Review, 28(2), 295–314. doi.org/10.1007/s10648-014-9287-x
- Snijders, T. A. B., & Bosker, R. J. (2012). Multilevel Analysis: An Introduction to Basic and Advanced Multilevel Modeling (2nd ed.). London: Sage.

Merveille Aganze Sami
Conseillère MEL & Gestion de Bases de Données. Plus de 9 ans d'expérience en suivi-évaluation, SIG et digitalisation auprès d'organisations internationales (GIZ, Enabel) en RD Congo.
Une analyse de données d'enquête à fiabiliser ?
Prendre contact